Por que um site pessoal tem deploy sem queda
Montar blue/green para um sistema pequeno parece exagero. Esta é a conta do que custa cair durante um deploy, do que custou montar a troca sem queda e do que ficou pior depois dela.
5 min de leitura
Decisões de arquitetura, .NET e sistemas distribuídos, escritas por quem vive com as consequências delas.
Montar blue/green para um sistema pequeno parece exagero. Esta é a conta do que custa cair durante um deploy, do que custou montar a troca sem queda e do que ficou pior depois dela.
Uma empresa de comércio exterior, que conduz processos de mudança para os clientes, recebia os pedidos de orçamento por e-mail, enviados por três plataformas de geração de leads. Alguém lia cada mensagem e copiava os dados à mão. Este texto conta cinco decisões que tomei ao construir o sistema que substituiu esse trabalho, e o que cada uma deixou pior.
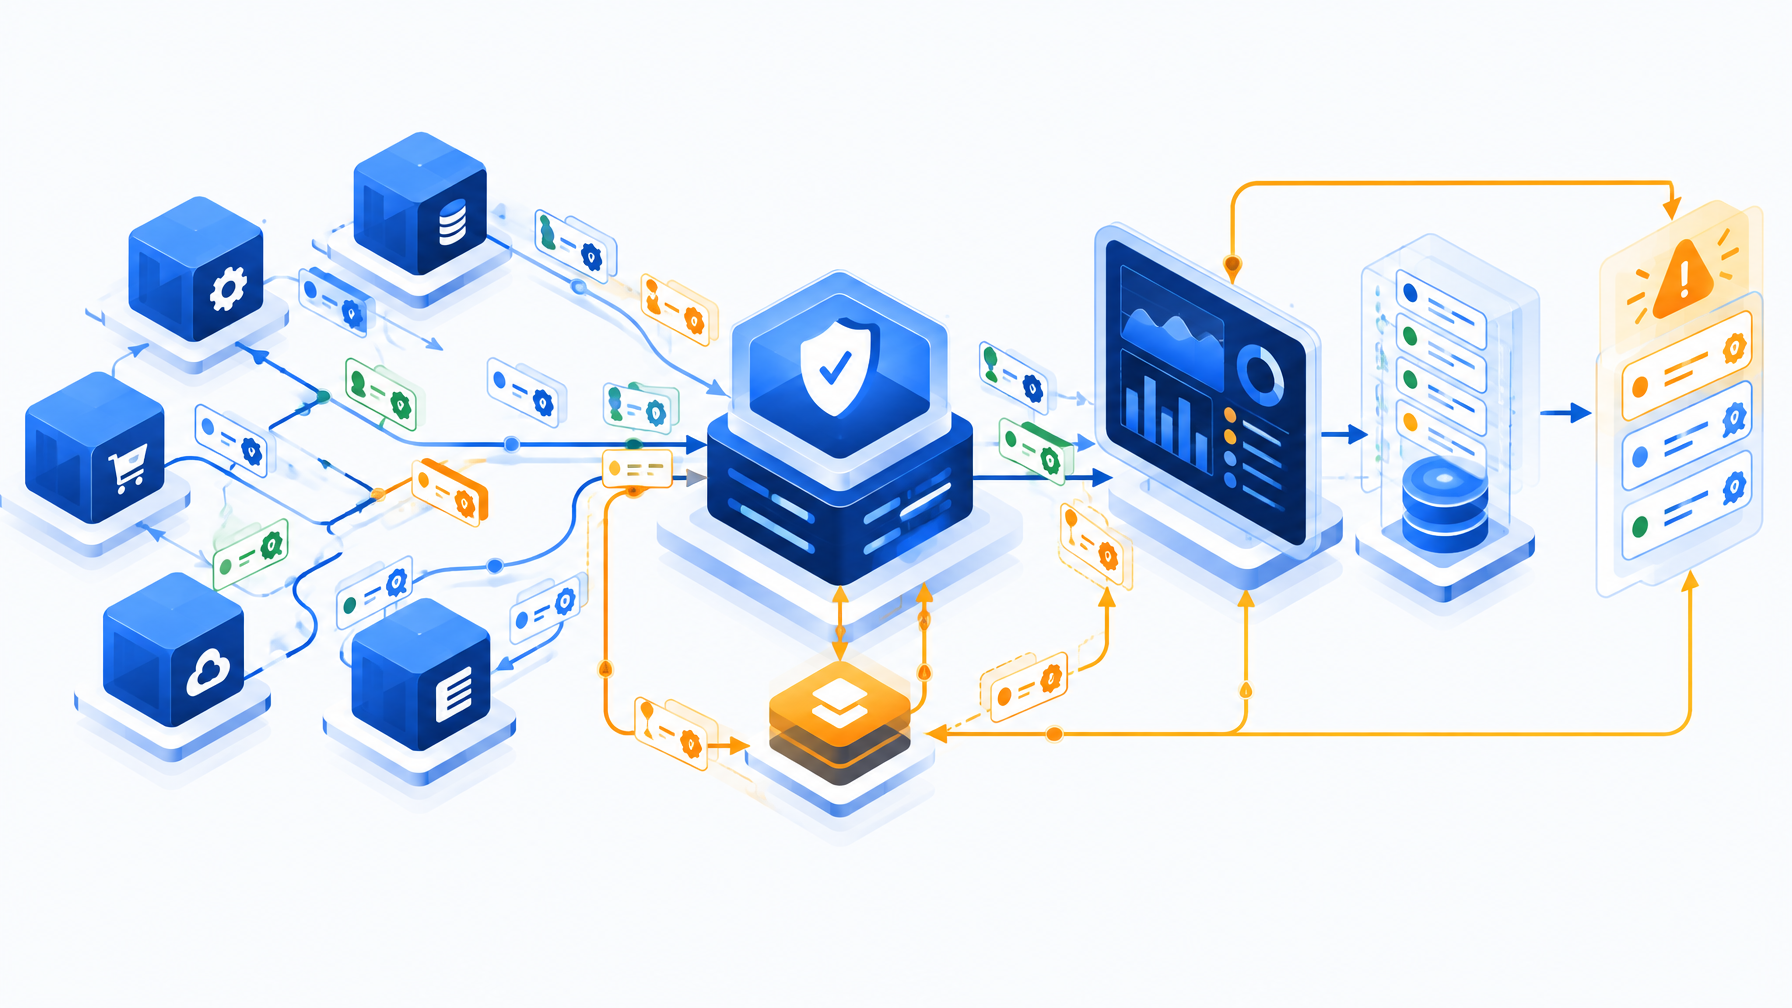
Gerenciar eventos em microsserviços requer governança e monitoramento detalhados para evitar inconsistências como perda e duplicação. Compartilho práticas de auditoria automatizada, dashboards e alertas baseados em minha experiência com sistemas event-driven.
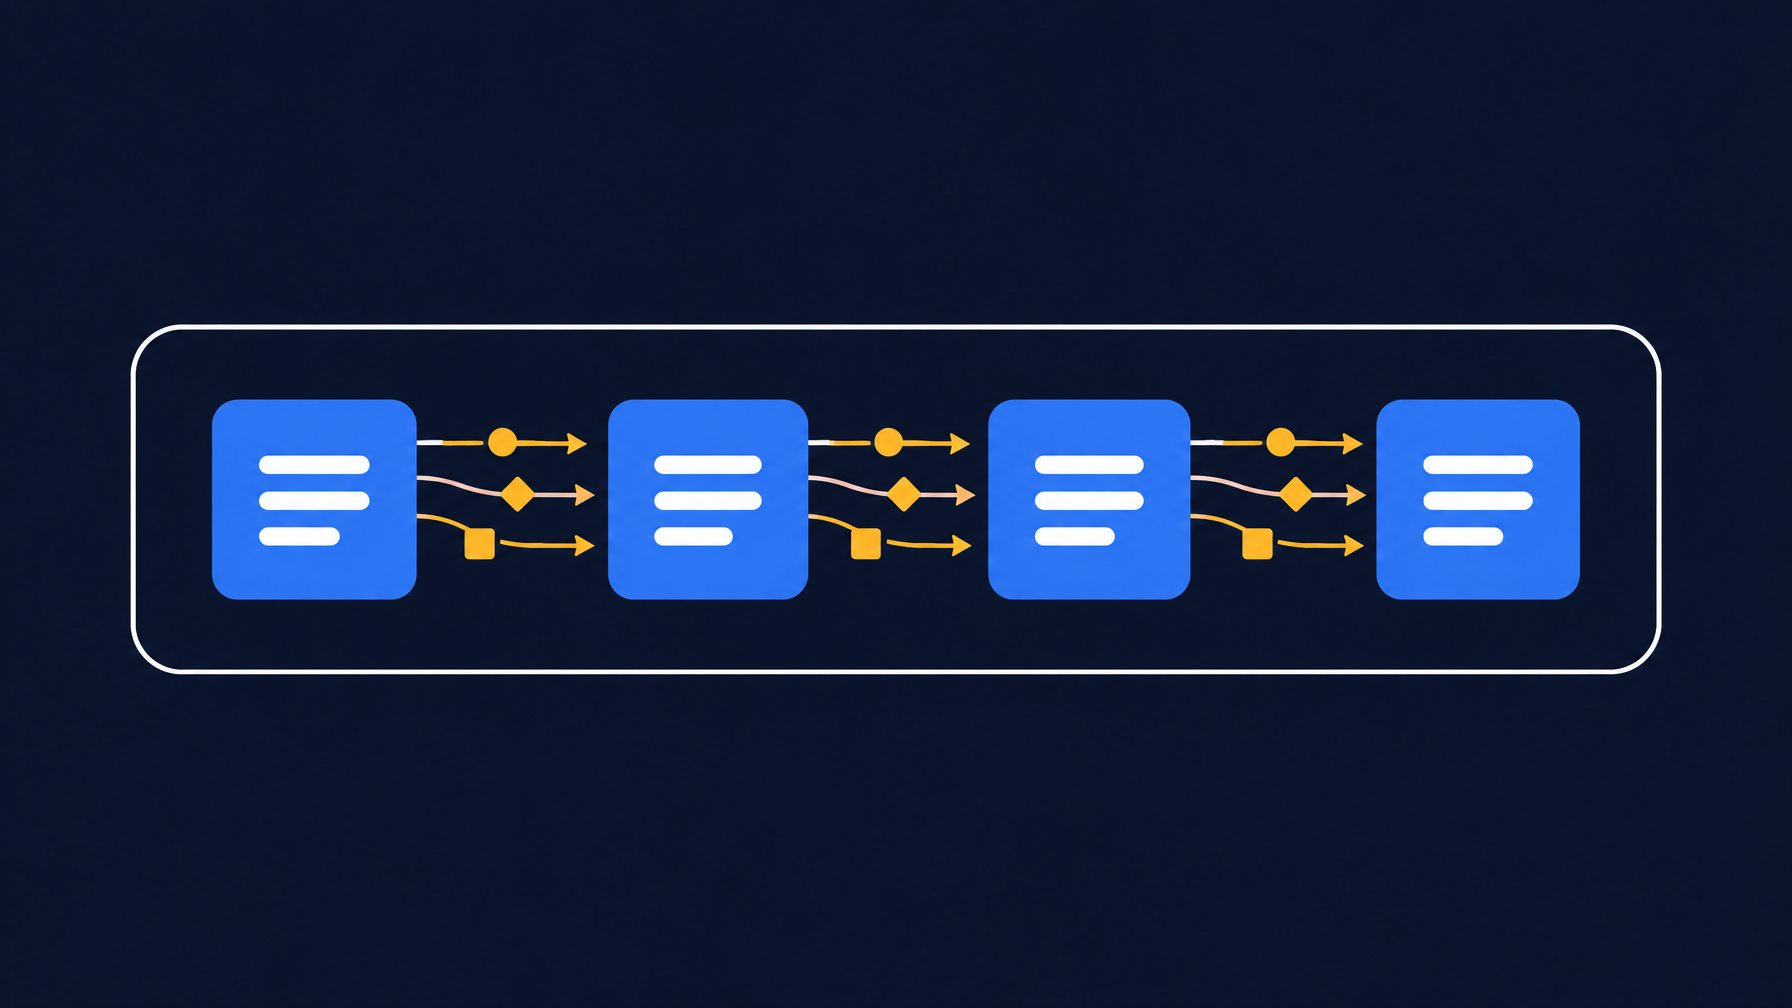
Este texto aprofunda um ponto do post sobre migração gradual de monólitos para microsserviços via event-driven architecture, detalhando como adotar eventos locais dentro do próprio monólito pode ajudar no desacoplamento entre módulos, simplificando evolução e testes.
Testes de integração com WebApplicationFactory e Testcontainers são fundamentais para sistemas event-driven, garantindo que fluxos de eventos e integrações assíncronas funcionem corretamente, evitando falhas de comunicação e possibilitando rollback seguro nas atualizações.
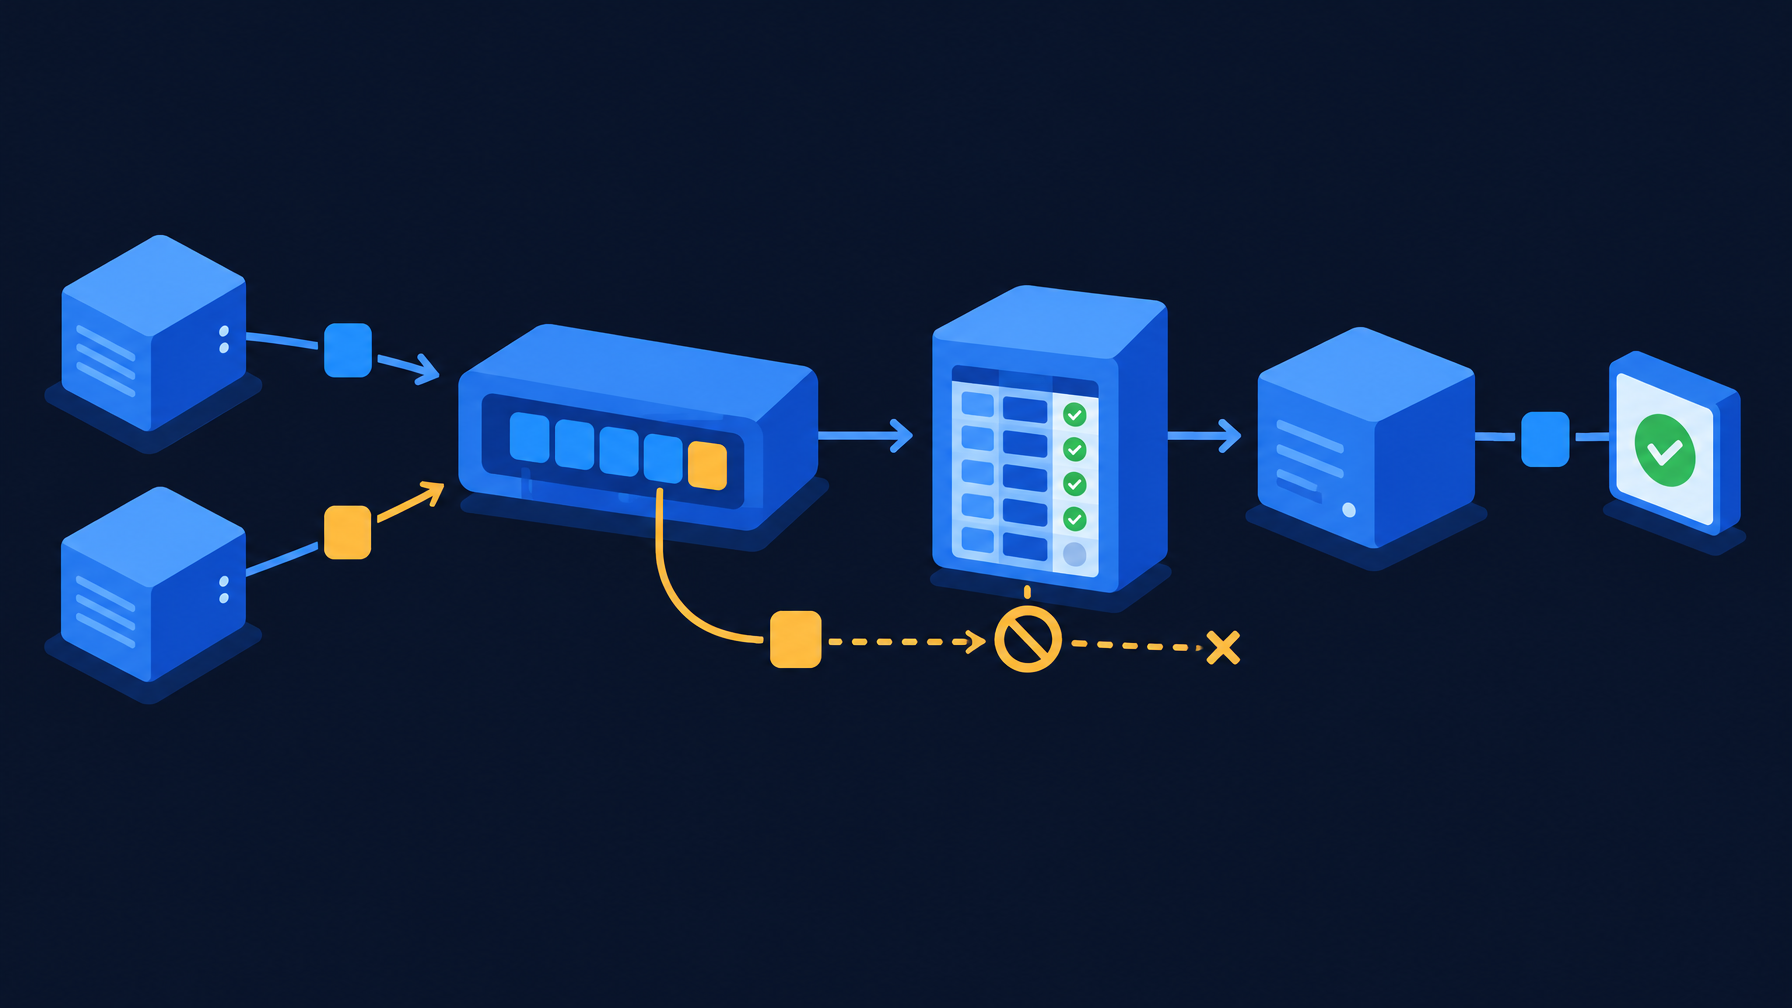
Neste texto, aprofundo o uso de padrões inbox e idempotência para assegurar o processamento único de eventos em arquiteturas event-driven, com foco prático na implementação em .NET e integração a testes robustos.
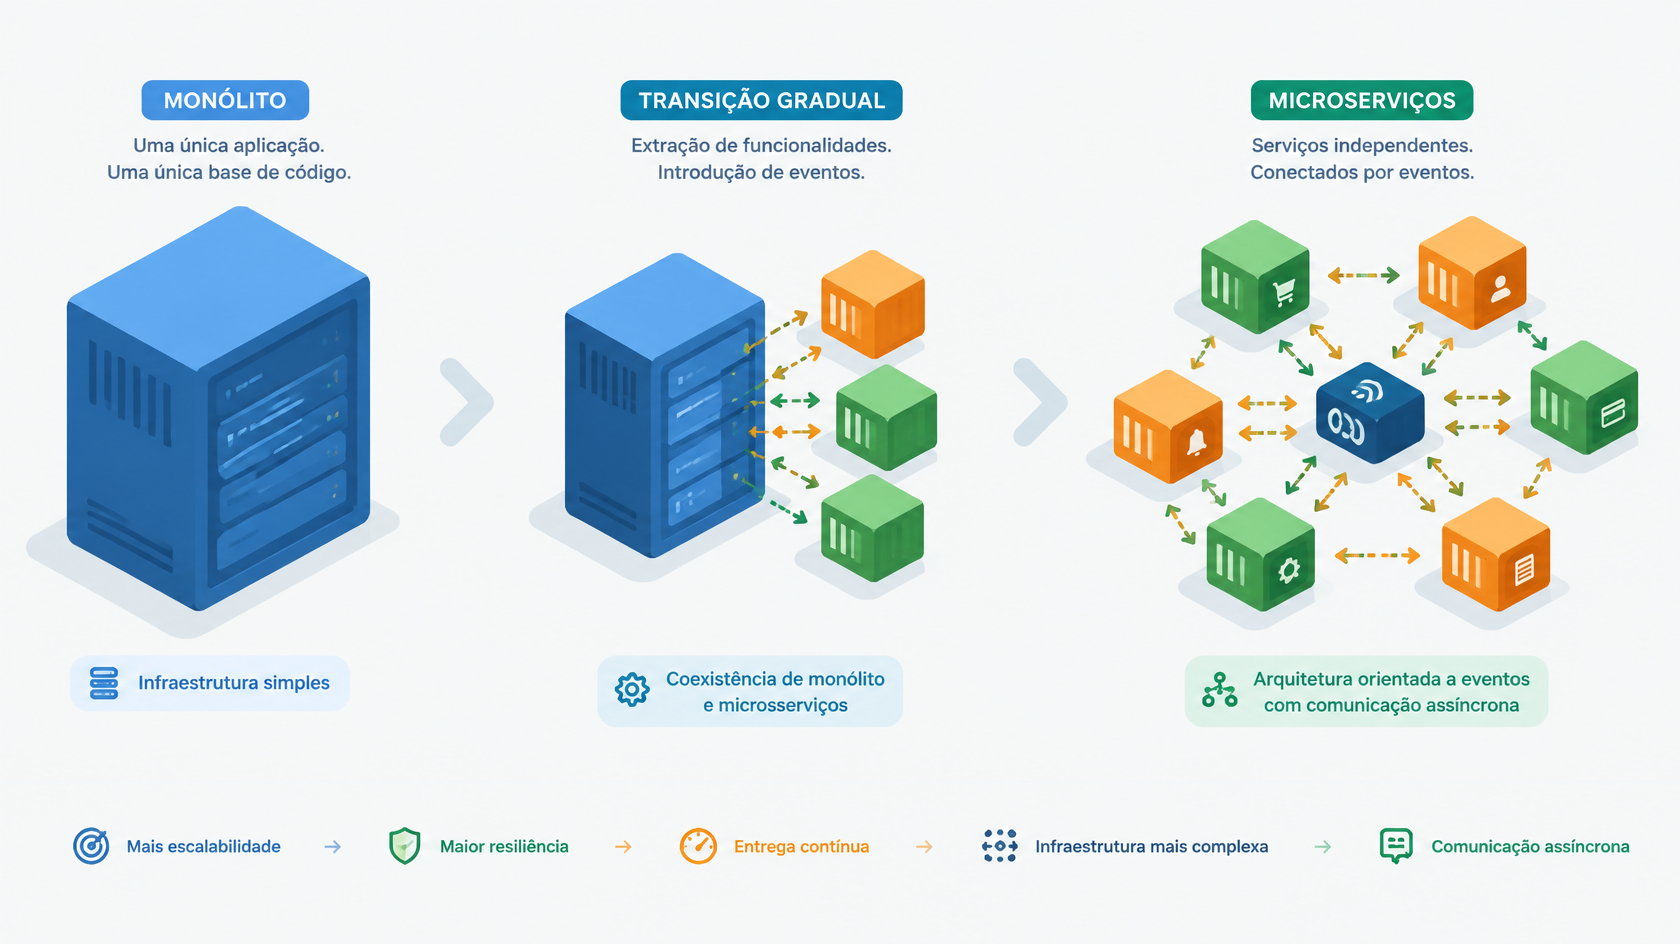
Migrar monólitos para microsserviços exige balancear desacoplamento gradual via eventos e manutenção da consistência. Estratégias focadas em arquiteturas event-driven ajudam a decompor sistemas legados passo a passo, minimizando riscos operacionais.
Automatizar rollback em pipelines CI/CD exige critérios claros de reversão, controle rigoroso de versão da base de dados e validação robusta do deploy para evitar impactos em produção. Na minha experiência, rollback automático só vale se migrations forem reversíveis e testadas.
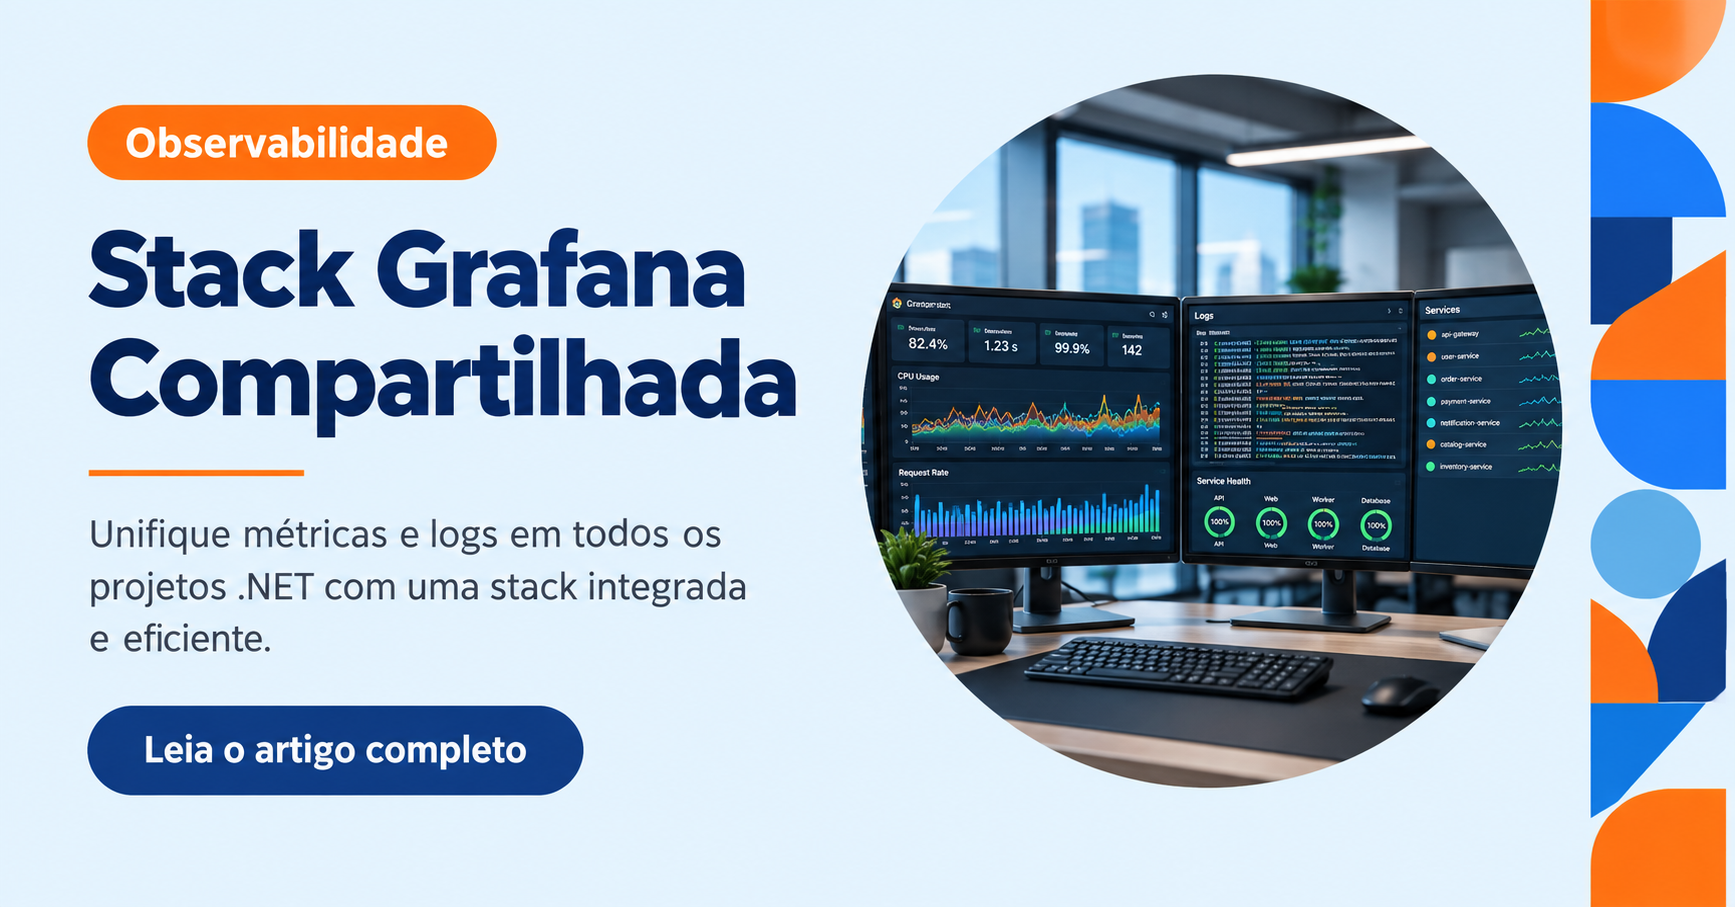
Centralizar a observabilidade de múltiplas aplicações .NET em uma stack externa com Grafana, Tempo, Prometheus e Loki reduz consumo de RAM, simplifica monitoramento e traz insights profundos via tracing distribuído.