Governança e monitoramento de eventos para evitar inconsistências em microsserviços
Gerenciar eventos em microsserviços requer governança e monitoramento detalhados para evitar inconsistências como perda e duplicação. Compartilho práticas de auditoria automatizada, dashboards e alertas baseados em minha experiência com sistemas event-driven.
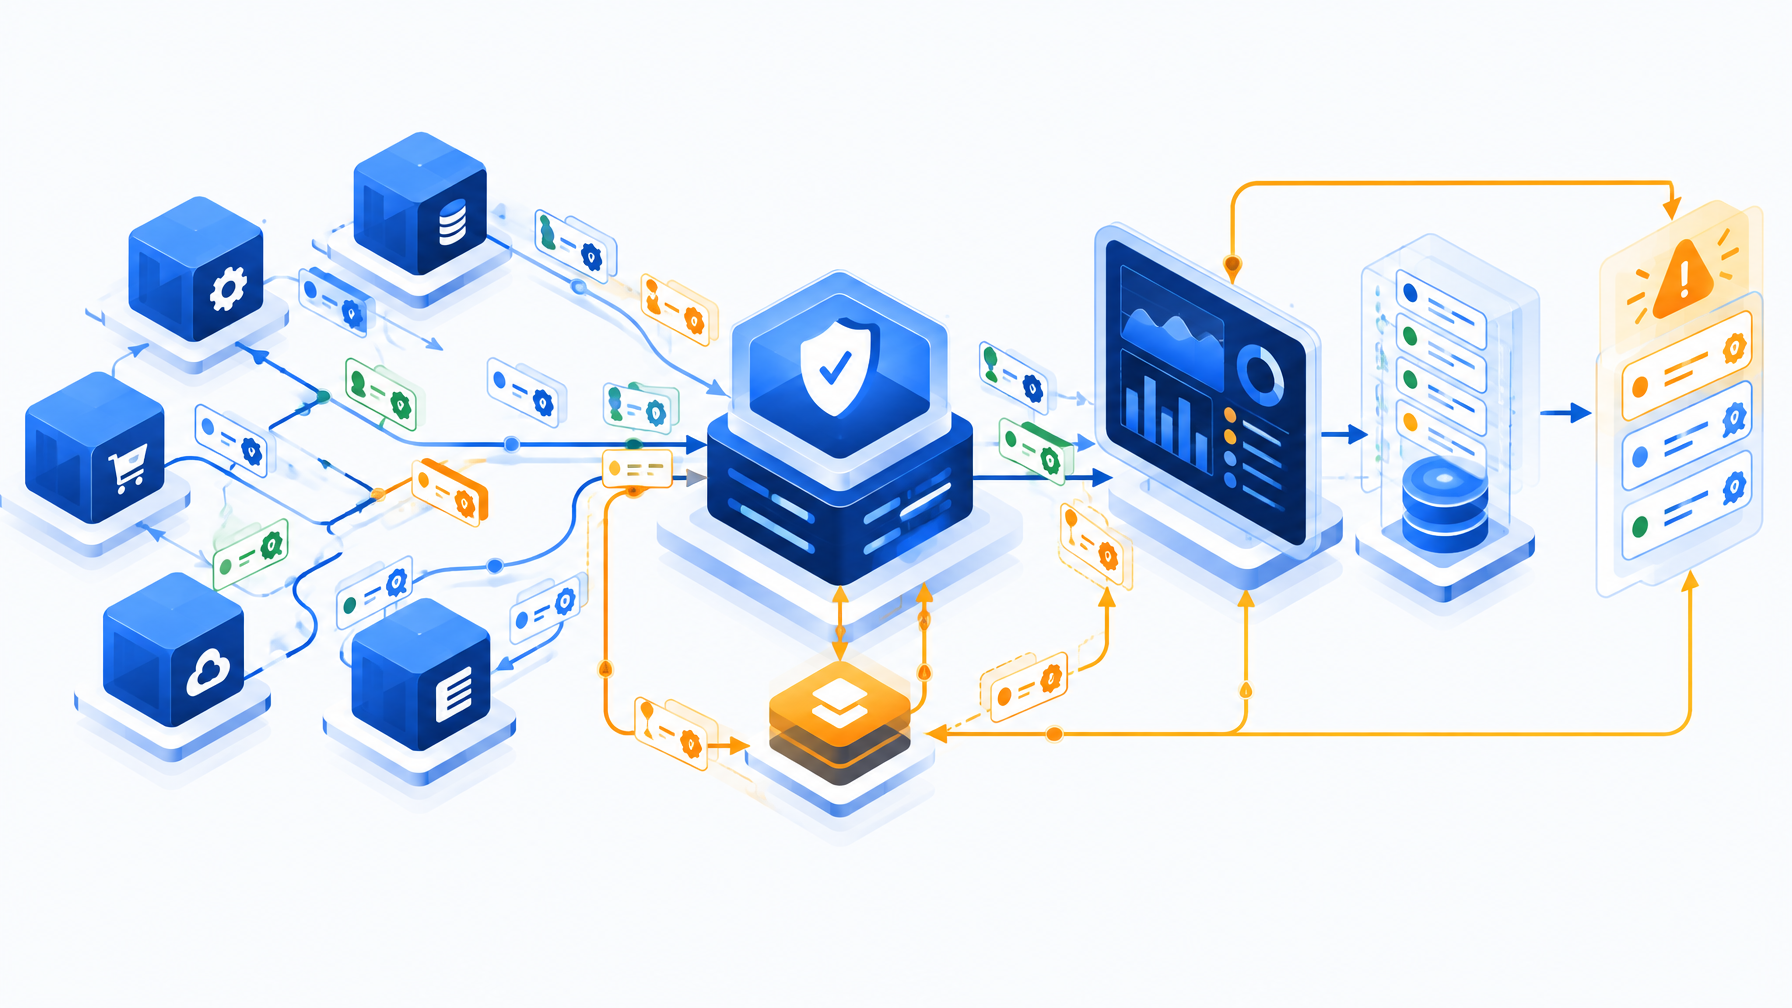
Em sistemas compostos por microsserviços, a governança e o monitoramento dos eventos são cruciais para evitar problemas operacionais que só aparecem em produção, como perda de mensagens, duplicações, ou inconsistências de estado. Este artigo aprofunda um ponto do meu post sobre migração gradual de monólitos para microsserviços usando Event-Driven Architecture, especificamente a necessidade de auditoria e governança automatizadas que muitos projetos acabam negligenciando.
Aqui não vamos discutir a arquitetura base nem a migração, mas sim o acompanhamento operacional dos eventos em ambientes distribuídos, mostrando como implementei soluções consistentes de monitoramento e governança para mitigar riscos de inconsistência e perda.
O desafio da governança de eventos na prática
Em um cenário ideal, toda mensagem disparada deve chegar ao destino uma e somente uma vez, na ordem correta, e eventual entidade ou processo precisa refletir o estado esperado. Entretanto, problemas comuns como falhas de rede, crashes, ou duplicações podem afetar esse fluxo:
- Perda de eventos quando o serviço emissor falha após a transação e antes de enviar o evento.
- Eventos duplicados por reenvios em casos de falha de confirmação.
- Desordem de eventos, causando divergência no estado dos consumidores.
- Processamento parcial ou falhas silenciosas que destroem a consistência.
Garantir que isso não vire um problema operacional pode passar por:
- Auditoria contínua que registra cada tentativa de entrega e confirmação de processamento para detectar falhas sutis ou eventos perdidos em picos de carga.
- Monitoramento centralizado com dashboards customizados que destacam padrões incomuns como replays excessivos ou sequência fora da ordem, problemas que enfrentamos ao operar em ambientes multi-tenant.
- Governança automatizada implementada com bloqueios preventivos em pipelines e nas APIs de publicação quando é identificado um evento duplicado ou fora da sequência esperada, evitando propagação de erros antes da correção manual.
Componentes da governança e monitoramento
1. Captura de eventos e metadados para auditoria
Todo evento que trafega em nossos sistemas inclui um identificador único global, carimbos de data/hora precisa, versão do schema controlada por semver para garantir compatibilidade, e a informação do tenant obtida diretamente do claim tenant_id do token JWT, garantindo correlação segura e consistente entre eventos e contexto multi-tenant. Para auditoria granular, capturamos e armazenamos também:
- Status da entrega (pendente, confirmado, falha).
- Tentativas de envio e recebimento.
- Logs de erros detalhados.
- Relationamento com dados da transação original (exemplo: ID da entidade que mudou).
Esse rastreamento fica em banco confiável e de alta disponibilidade, separado do mecanismo de mensageria, para consulta e análise independente.
2. Dashboards customizados para monitoramento de eventos
Criei dashboards em Grafana para centralizar vários indicadores:
- Contagem de eventos publicados por tópico e serviço.
- Taxa de eventos com erro ou falha no processamento.
- Tentativas de reprocessamento e eventos duplicados detectados.
- Delay e latência entre publicação e consumo.
- Anomalias como “dead letters” ou filas estagnadas.
Esses dados são coletados por exporters e integrados ao Prometheus, com traces distribuídos via OpenTelemetry para rastreamento de fluxos end-to-end.
flowchart TD
  Event_Producer["Serviço produtor"] -->|Publica evento| Message_Broker["Broker de mensagens"]
  Message_Broker --> Consumer_Service["Serviço consumidor"]
  Message_Broker --> Auditoria_DB["Banco de auditoria"]
  Auditoria_DB --> Grafana["Dashboard Grafana"]
  Consumer_Service -->|Confirma| Auditoria_DB
  Event_Producer -->|Confirma| Auditoria_DB
3. Alertas automatizados para prevenção e intervenção rápida
Configurei alertas via Prometheus Alertmanager com notificações no Telegram para:
- Atraso excessivo entre envio e consumo.
- Aumento súbito ou padrão repetido de falha em eventos.
- Dead-letter acumulada acima do limite.
- Divergências de contagem entre eventos emitidos e processados.
- Violações nas regras de sequência de eventos.
Esses alertas são um gatilho imediato para o time operacional, permitindo investigação rápida. Além disso, operamos alguns gatilhos automatizados para bloquear publicações quando detectar anomalias críticas, evitando amplificação do problema.
Exemplo prático: monitorando idempotência em processamento de eventos
Uma fonte frequente de inconsistência é o processamento duplicado, especialmente em sistemas que optam por retry manual. Para controlar esse problema, implementei uma tabela de controle de processamento com chaves únicas por evento:
// Exemplo ilustrativo de controle de idempotência no consumidor
public class EventProcessor
{
    private readonly DbContext _db;

    public EventProcessor(DbContext db)
    {
        _db = db;
    }

    public async Task<bool> ProcessEventAsync(EventDto evt)
    {
        var exists = await _db.ProcessedEvents.AnyAsync(e => e.EventId == evt.Id);
        if (exists) return false; // Ignorar duplicado

        // Processa o evento
        await HandleEvent(evt);

        // Marca evento como processado
        _db.ProcessedEvents.Add(new ProcessedEvent { EventId = evt.Id, ProcessedAt = DateTime.UtcNow });
        await _db.SaveChangesAsync();

        return true;
    }
}
Esse dado alimenta nossas consultas e alertas, que já permitiram identificar e reduzir em 30% as duplicações em produção. Quando ocorre disparo de alertas, investigamos possíveis falhas no ack do broker, bugs ou problemas de infraestrutura.
Considerações de governança automatizada
Governança vai além de monitorar: inclui regras que impedem situações erradas. Em alguns projetos, como o sistema de comércio exterior que gerencio, os seguintes controles são automáticos:
- Envio rejeitado se evento com ID já estiver pendente ou processado na sequência errada.
- Deploy só permitido se os testes de arquitetura e integrações sobre eventos estiverem limpos.
- Em pipelines, releases travam com falha de alertas críticos relacionados a eventos.
Governar os agentes que produzem e consomem eventos por código (via Rules as Code) e por testes automatizados é uma camada importante para evitar a complexidade oculta que mencionei no post original.
Armadilhas comuns
- Ignorar o armazenamento persistente do histórico dos eventos dificulta auditoria;
- Subestimar latências e erros temporários desconfigura alertas;
- Não considerar a orquestração da governança com pipelines e qualidade do código;
- Usar ferramentas de monitoramento genéricas sem captura do contexto completo dos eventos;
- Falha ao alinhar o escopo do monitoramento com o SLA e prioridades do negócio.
O que fazer a seguir
Avalie o seu ambiente e comece mapeando os eventos críticos e os pontos que não são bem visíveis. Inclua captura de metadados e log de falhas granular. Monte dashboards que mostrem cenários de risco e configure alertas diretamente conectados à equipe que pode agir. Lembre que governança automatizada inclui testes e regras que bloqueiam operações inseguras em código e pipeline.
Mesmo com custo operacional, essa abordagem contribui para evitar surpresas e fazer o sistema escalar sem descontrole.
Referências
- Estratégias para migração gradual de monólitos para microsserviços usando Event-Driven Architecture: Contexto e desafios da governança de eventos.
- Observabilidade compartilhada: uma stack Grafana para todos os meus projetos: Implementação prática do monitoramento centralizado.
- PostgreSQL: Documentation: Monitoramento e auditoria em banco relacional.
- OpenTelemetry Documentation: Práticas atuais para tracing distribuído e geração de métricas.
Receba o resumo da semana
Um e-mail por semana com o que foi publicado. Sem spam, e você sai quando quiser.
Continue lendo
- Do e-mail copiado à mão ao funil num sistema só: cinco decisões e o que cada uma custouUma empresa de comércio exterior, que conduz processos de mudança para os clientes, recebia os pedidos de orçamento por e-mail, enviados por três plataformas de geração de leads. Alguém lia cada mensagem e copiava os dados à mão. Este texto conta cinco decisões que tomei ao construir o sistema que substituiu esse trabalho, e o que cada uma deixou pior.
- Event-driven interno: desacoplamento por eventos locais em monólitos moduladosEste texto aprofunda um ponto do post sobre migração gradual de monólitos para microsserviços via event-driven architecture, detalhando como adotar eventos locais dentro do próprio monólito pode ajudar no desacoplamento entre módulos, simplificando evolução e testes.
- Testes de integração com WebApplicationFactory e Testcontainers em ambientes event-drivenTestes de integração com WebApplicationFactory e Testcontainers são fundamentais para sistemas event-driven, garantindo que fluxos de eventos e integrações assíncronas funcionem corretamente, evitando falhas de comunicação e possibilitando rollback seguro nas atualizações.